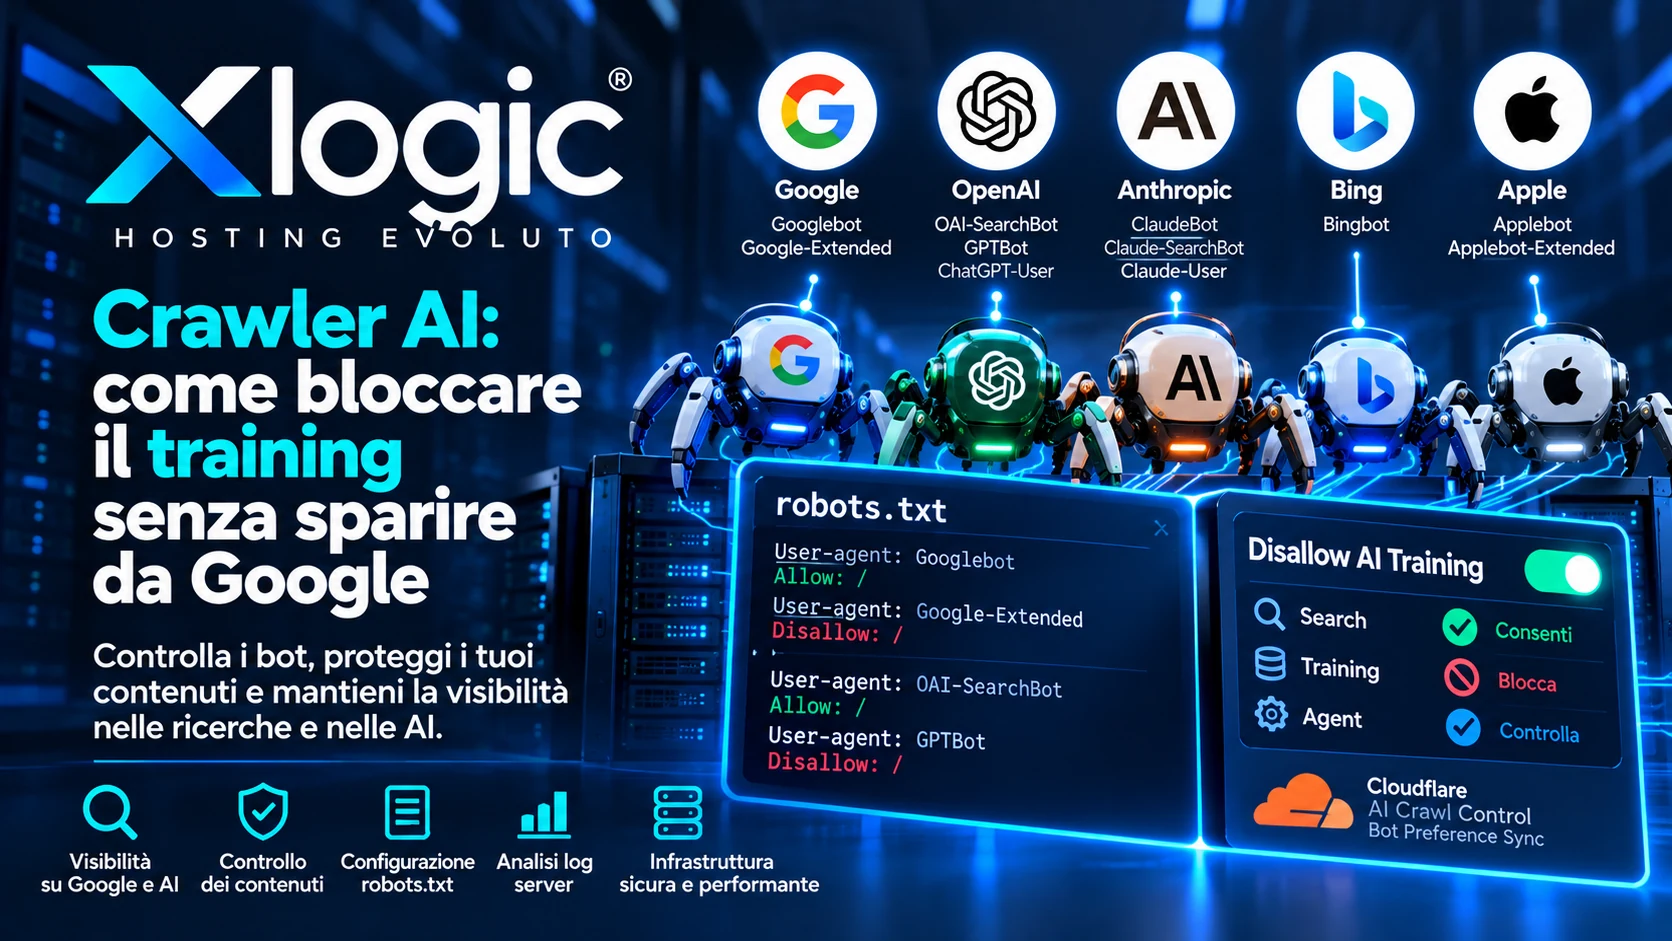
Crawler AI, bot per la ricerca, crawler per l’addestramento dei modelli e agenti che visitano una pagina su richiesta dell’utente non sono necessariamente la stessa cosa.
Capire questa differenza è diventato fondamentale per chi gestisce un sito Web.
Bloccare indiscriminatamente tutti i bot associati all’intelligenza artificiale potrebbe infatti ridurre la possibilità che un sito venga trovato attraverso servizi come ChatGPT, Claude o altri sistemi di ricerca basati sull’AI.
Allo stesso tempo, lasciare accesso a qualsiasi crawler significa rinunciare a una parte del controllo su come i propri contenuti possono essere utilizzati.
Nel settembre 2026 Cloudflare ha introdotto nuove funzioni che separano più chiaramente tre categorie:
Search;
Training;
Agent.
La novità più interessante si chiama Disallow AI Training e parte da un principio semplice:
un sito può voler essere trovato nelle ricerche AI senza voler autorizzare l’utilizzo dei propri contenuti per l’addestramento dei modelli.
Vediamo quindi come funzionano i principali crawler AI, quali bot è importante distinguere e come evitare di compromettere accidentalmente la visibilità del proprio sito.
Crawler AI: perché non sono tutti uguali?
Quando nei log di un server compare un bot associato a una società AI, non significa automaticamente che quella visita serva ad addestrare un modello.
Lo stesso ecosistema può utilizzare crawler differenti per scopi differenti.
Le principali categorie sono:
Categoria
Funzione
Search
Scopre e indicizza contenuti da utilizzare nei risultati di ricerca
Training
Raccoglie contenuti che possono contribuire all’addestramento dei modelli
Agent
Visita una pagina perché un utente o un agente AI ha richiesto direttamente quell’informazione
La differenza è fondamentale.
Un bot Search può portare visibilità.
Un bot Training ha invece una finalità diversa.
Un Agent può arrivare sul sito soltanto nel momento in cui un utente sta chiedendo a un sistema AI di consultare quella pagina.
La novità Cloudflare: Disallow AI Training
Il 15 settembre 2026 Cloudflare ha annunciato una nuova impostazione chiamata:
Disallow AI Training
L’obiettivo è consentire al proprietario del sito di esprimere una preferenza contraria all’utilizzo dei contenuti per il training senza necessariamente eliminare il sito dai sistemi di ricerca.
Cloudflare ha inoltre riorganizzato i controlli dei bot AI nelle categorie:
Attenzione: “Block” e “Disallow AI Training” non sono la stessa cosa
Questa distinzione è particolarmente importante.
Cloudflare spiega che selezionando Block per alcuni crawler mixed-use come Googlebot, Applebot o Bingbot si può impedire anche la normale scansione destinata alla ricerca.
Questo potrebbe avere conseguenze sulla visibilità.
Disallow AI Training tenta invece di mantenere disponibile la scansione Search mentre comunica o applica il divieto relativo al training, dove il crawler e i controlli disponibili lo consentono.
OpenAI utilizza crawler separati
OpenAI documenta ufficialmente diversi user-agent con funzioni differenti.
I tre più importanti per un normale sito Web sono:
OAI-SearchBot;
GPTBot;
ChatGPT-User.
Non devono essere considerati equivalenti.
OAI-SearchBot: il crawler per ChatGPT Search
OAI-SearchBot viene utilizzato da OpenAI per permettere ai siti Web di comparire nelle funzionalità di ricerca di ChatGPT.
OpenAI specifica che un sito che esclude OAI-SearchBot non sarà normalmente mostrato nelle risposte di ChatGPT Search come risultato di ricerca, anche se può ancora comparire come collegamento di navigazione in alcuni casi.
Se l’obiettivo è ottenere visibilità nelle ricerche di ChatGPT, questo è quindi uno dei crawler che è importante non bloccare accidentalmente.
La documentazione ufficiale è disponibile nella pagina OpenAI Crawlers.
GPTBot: il crawler legato al training
GPTBot ha invece una funzione differente.
OpenAI lo descrive come il crawler utilizzato per raccogliere contenuti che possono contribuire a rendere più utili e sicuri i propri modelli generativi.
Bloccare GPTBot nel file robots.txt comunica che i contenuti del sito non devono essere utilizzati attraverso quel crawler per l’addestramento dei modelli generativi.
Ed è proprio qui che emerge la differenza:
puoi consentire OAI-SearchBot e bloccare GPTBot.
In questo modo mantieni separata la scelta relativa alla ricerca da quella relativa al training.
ChatGPT-User: quando è l’utente a chiedere la pagina
Esiste poi ChatGPT-User.
Questo user-agent può comparire quando un utente chiede direttamente a ChatGPT o a un GPT di consultare una pagina.
Non è un crawler automatico utilizzato per costruire l’indice Search.
OpenAI specifica inoltre che, trattandosi di accessi iniziati dall’utente, le normali regole di robots.txt potrebbero non essere applicabili nello stesso modo utilizzato dai crawler automatici.
OpenAI: Search e Training possono essere gestiti separatamente
Bot OpenAI
Utilizzo principale
Se lo blocchi
OAI-SearchBot
ChatGPT Search
Può ridurre la visibilità nelle ricerche ChatGPT
GPTBot
Training dei modelli
Non blocca OAI-SearchBot
ChatGPT-User
Accessi richiesti dall’utente
Può impedire determinate visite richieste dagli utenti
Anthropic distingue Training, Search e richieste degli utenti
Anche Anthropic utilizza bot differenti.
I principali documentati sono:
ClaudeBot;
Claude-SearchBot;
Claude-User.
ClaudeBot: il crawler di training Anthropic
ClaudeBot viene utilizzato per raccogliere contenuti Web che potrebbero contribuire allo sviluppo e al training dei modelli Anthropic.
Anthropic specifica che limitare ClaudeBot tramite robots.txt segnala che i materiali futuri del sito devono essere esclusi dai dataset di training generati attraverso questo crawler.
Claude-SearchBot: il crawler per la ricerca
Claude-SearchBot ha invece una funzione dedicata alla ricerca.
Anthropic lo descrive come il bot che naviga nel Web per migliorare la qualità dei risultati di ricerca forniti agli utenti.
Bloccarlo può quindi ridurre la possibilità che i contenuti del sito vengano correttamente individuati e utilizzati nelle esperienze di ricerca di Claude.
Claude-User
Claude-User viene utilizzato quando un utente Claude richiede informazioni che comportano l’accesso a una pagina Web.
Anche in questo caso abbiamo quindi una separazione tra:
Googlebot e Google-Extended non sono la stessa cosa
Anche Google consente di esprimere una preferenza specifica relativa a determinati utilizzi AI attraverso:
Google-Extended
Questo nome può creare confusione.
Google-Extended non è un normale user-agent HTTP separato come Googlebot.
È un token utilizzabile nel file robots.txt per controllare determinati utilizzi dei contenuti da parte dei sistemi generativi di Google.
Google-Extended influenza il ranking Google?
Secondo la documentazione ufficiale Google:
no.
L’utilizzo di Google-Extended non influisce sull’inclusione del sito nella Ricerca Google e non viene utilizzato come segnale di ranking.
Google-Extended permette invece ai publisher di controllare determinati utilizzi dei contenuti relativi ai modelli Gemini e ai relativi sistemi di grounding.
La documentazione è disponibile nella pagina Google Crawlers.
Quindi posso bloccare Google-Extended ma lasciare Googlebot?
Sì.
È proprio questo uno degli esempi più chiari di separazione tra ricerca tradizionale e utilizzo AI.
In questo modo Googlebot continua a poter effettuare la normale scansione destinata a Google Search, mentre viene espressa una preferenza diversa per Google-Extended.
Applebot e Applebot-Extended
Anche Apple permette di distinguere tra il normale crawler Applebot e l’utilizzo relativo all’addestramento attraverso:
Applebot-Extended
Cloudflare cita proprio Apple come uno degli operatori che permette di esprimere preferenze separate relative al training.
Bloccare indiscriminatamente Applebot, invece, può coinvolgere anche le normali funzioni di ricerca Apple.
Bingbot richiede particolare attenzione
Il caso di Bingbot è leggermente differente.
Nel settembre 2026 Microsoft consente di esprimere determinate preferenze sull’utilizzo AI attraverso direttive come NOARCHIVE e strumenti di Bing Webmaster.
Cloudflare indica inoltre che Microsoft sta lavorando a un meccanismo dedicato per comunicare attraverso robots.txt una preferenza “no training” a livello di sito.
La disponibilità completa di questo meccanismo è prevista successivamente.
Per questo non è consigliabile aggiungere semplicemente:
User-agent: Bingbot
Disallow: /
se vuoi continuare a essere visibile su Bing.
Bloccheresti infatti il crawler principale della ricerca.
Tabella: quali crawler AI conviene distinguere?
Crawler / controllo
Funzione
Impatto potenziale del blocco
Googlebot
Google Search
Può compromettere l’indicizzazione Google
Google-Extended
Determinati utilizzi AI Google
Google dichiara che non influenza il ranking Search
OAI-SearchBot
ChatGPT Search
Può ridurre la presenza nelle ricerche ChatGPT
GPTBot
Training OpenAI
Non equivale a bloccare OAI-SearchBot
ChatGPT-User
Visite richieste dagli utenti ChatGPT
Può limitare l’accesso diretto richiesto dagli utenti
ClaudeBot
Training Anthropic
Può essere escluso separatamente dai bot Search
Claude-SearchBot
Ricerca Claude
Può ridurre la visibilità nelle ricerche Claude
Claude-User
Richieste effettuate dagli utenti Claude
Può impedire il recupero richiesto dall’utente
Applebot
Ricerca Apple
Bloccarlo può incidere sulla ricerca
Applebot-Extended
Preferenza relativa al training
Può essere gestito separatamente
Bingbot
Bing Search e altri utilizzi
Non va bloccato indiscriminatamente se vuoi Bing Search
Un esempio di robots.txt per consentire la ricerca ma limitare il training
Una configurazione semplificata può essere simile alla seguente:
Prima di modificare il proprio robots.txt bisogna valutare quali servizi si desidera effettivamente autorizzare e verificare la documentazione aggiornata di ogni crawler.
Le regole e gli user-agent possono cambiare nel tempo.
Non inserire Disallow: / per tutti i crawler alla cieca
Una configurazione come questa:
User-agent: *
Disallow: /
blocca teoricamente tutti i crawler che rispettano robots.txt.
Questo comprende anche motori di ricerca tradizionali.
Su un sito pubblico che vuole essere indicizzato sarebbe quindi normalmente una scelta sbagliata.
robots.txt non è un firewall
Questo punto è fondamentale.
Il file robots.txt è principalmente uno strumento attraverso il quale il proprietario del sito comunica le proprie preferenze ai crawler.
Non rappresenta una barriera tecnica equivalente a un firewall.
Un bot che decide di ignorare queste regole potrebbe comunque tentare di effettuare richieste.
Per un blocco tecnico sono necessari strumenti come:
firewall;
WAF;
Bot Management;
regole server;
controlli CDN;
rate limiting.
Cloudflare Bot Preference Sync
Cloudflare ha introdotto anche Bot Preference Sync.
Lo scopo è sincronizzare le preferenze impostate dal proprietario del sito con le direttive utilizzate dai diversi crawler.
In pratica, invece di dover seguire manualmente ogni cambiamento introdotto dai vari operatori, Cloudflare può aggiornare automaticamente le preferenze comunicate nel file robots.txt.
Questo può risultare utile perché il panorama dei crawler AI cambia rapidamente.
Disallow AI Training blocca fisicamente tutti i crawler?
Non sempre nello stesso modo.
Cloudflare distingue tra:
comunicare una preferenza attraverso robots.txt;
bloccare direttamente un crawler attraverso i sistemi Bot Management.
Per i crawler dedicati esclusivamente al training di operatori come OpenAI e Anthropic, Cloudflare può bloccare il relativo traffico senza dover bloccare anche il crawler Search separato.
Cosa succede con i crawler mixed-use?
Alcune organizzazioni utilizzano o hanno utilizzato crawler che possono essere impiegati per più finalità.
Cloudflare indica come esempi:
Googlebot;
Applebot;
Bingbot.
Per questi crawler è ancora più importante evitare il blocco completo se l’obiettivo è continuare a ricevere traffico dai rispettivi sistemi di ricerca.
OpenAI e Anthropic semplificano la separazione
Secondo Cloudflare, operatori come OpenAI e Anthropic utilizzano crawler distinti per le finalità Search e Training.
Questo rende tecnicamente più semplice applicare una politica del tipo:
ricerca sì, training no.
È una differenza importante rispetto ai crawler multipurpose.
Bloccare il training migliora la SEO?
No.
Bloccare o consentire un crawler di training non rappresenta automaticamente un fattore SEO.
La questione riguarda soprattutto:
controllo dei contenuti;
training AI;
visibilità nelle ricerche AI;
politiche editoriali;
gestione del traffico bot.
La SEO tradizionale continua a dipendere da molti altri segnali.
AI Search, AEO e GEO: perché i crawler diventano importanti
Con la crescita dei motori di risposta AI, il sito può essere scoperto attraverso percorsi diversi dalla classica pagina dei risultati Google.
Per questo si parla sempre più di:
SEO;
AEO – Answer Engine Optimization;
GEO – Generative Engine Optimization.
Essere tecnicamente accessibili ai crawler Search delle piattaforme AI è soltanto uno dei requisiti.
Non garantisce che il contenuto venga citato.
Servono comunque:
contenuti utili;
informazioni chiare;
fonti;
struttura HTML corretta;
dati verificabili;
buona reputazione;
pagine accessibili.
OAI-SearchBot garantisce di apparire in ChatGPT?
No.
Consentire il crawler significa rendere il sito eleggibile alla scoperta attraverso il sistema Search.
OpenAI specifica però che la presenza nei risultati non è garantita.
I sistemi di ricerca utilizzano diversi fattori per determinare quali risultati mostrare.
Googlebot garantisce di apparire su Google?
Neppure in questo caso.
Consentire Googlebot è un requisito tecnico per permettere la scansione, ma Google decide autonomamente:
se indicizzare una pagina;
quando scansionarla;
come classificarla;
per quali query mostrarla.
La stessa distinzione è utile quando si parla di crawler AI.
Come capire quali bot AI stanno visitando realmente il sito
Il metodo più affidabile è controllare i log Web del server.
Ogni richiesta HTTP contiene normalmente uno user-agent.
Questi dati permettono di capire quali sistemi stanno realmente visitando il sito.
Controlla anche il codice HTTP restituito
Non basta vedere il nome del crawler.
È importante verificare anche la risposta restituita dal server.
Per esempio:
200 → pagina raggiungibile;
301 → redirect;
302 → redirect temporaneo;
403 → accesso negato;
404 → pagina non trovata;
429 → troppe richieste;
5xx → errore server.
Se OAI-SearchBot riceve continuamente 403 Forbidden, permetterlo nel robots.txt non è sufficiente.
Potrebbe esserci un firewall che lo blocca.
robots.txt può dire “Allow” mentre il firewall blocca comunque
Sì.
È un errore piuttosto comune.
Puoi avere:
User-agent: OAI-SearchBot
Allow: /
ma contemporaneamente una regola firewall, CDN o sistema antispam che risponde:
403 Forbidden
In quel caso il crawler non riesce comunque ad accedere al contenuto.
Verifica che il bot sia realmente quello dichiarato
Lo user-agent può essere falsificato.
Un bot malevolo potrebbe presentarsi come:
Googlebot
oppure:
GPTBot
senza appartenere realmente a Google o OpenAI.
Quando possibile è quindi opportuno utilizzare i metodi di verifica pubblicati dal relativo operatore, come gli intervalli IP ufficiali o altri meccanismi di autenticazione disponibili.
OpenAI pubblica gli IP dei propri crawler
OpenAI pubblica intervalli IP dedicati per:
OAI-SearchBot;
GPTBot;
ChatGPT-User.
Questo consente a hosting provider, firewall e CDN di verificare più accuratamente il traffico e applicare regole specifiche.
Anthropic e gli indirizzi IP
La documentazione Anthropic indica invece che attualmente i suoi bot possono utilizzare indirizzi pubblici forniti da service provider e che Anthropic non pubblica necessariamente range IP permanenti equivalenti a quelli utilizzati da alcuni altri crawler.
Per questo Anthropic raccomanda principalmente di utilizzare le direttive robots.txt per comunicare le preferenze relative ai propri bot.
Cosa fare se vuoi essere trovato dalle AI?
Se il tuo obiettivo è aumentare la probabilità che i contenuti vengano scoperti dai motori AI, controllerei almeno:
OAI-SearchBot;
Claude-SearchBot;
Googlebot;
Bingbot;
Applebot.
Successivamente verificherei nei log che le richieste ricevano realmente risposta 200.
Cosa fare se non vuoi consentire il training?
Puoi invece valutare controlli specifici dedicati ai crawler o token di training, come:
GPTBot;
ClaudeBot;
Google-Extended;
Applebot-Extended;
eventuali controlli specifici messi a disposizione da Cloudflare o dagli altri operatori.
La configurazione corretta dipende dalla politica del sito.
Una possibile strategia per un sito aziendale
Per molti siti aziendali potrebbe avere senso adottare una strategia simile:
Tipo
Politica possibile
Motori Search
Allow
AI Search
Allow
Training
Scelta editoriale del proprietario
Agent richiesti dall’utente
Generalmente Allow se si vuole visibilità
Bot sconosciuti/aggressivi
Limitazione o blocco
Non esiste una scelta corretta per tutti
Un sito editoriale potrebbe non voler consentire il training dei propri articoli.
Un progetto open source potrebbe invece desiderare la massima accessibilità.
Un eCommerce potrebbe essere interessato soprattutto a:
ricerca;
product discovery;
shopping assistant;
agent AI.
La configurazione deve quindi riflettere gli obiettivi reali del sito.
Crawler AI e consumo di risorse server
Esiste anche un’altra questione: il traffico generato dai bot consuma risorse.
Un crawler particolarmente aggressivo può aumentare:
richieste PHP;
carico CPU;
query database;
banda;
accessi al disco;
dimensione dei log.
Per questo consentire un crawler non significa necessariamente lasciargli effettuare un numero illimitato di richieste.
Cache e crawler AI
Un sistema di cache correttamente configurato può ridurre notevolmente l’impatto dei bot sulle pagine pubbliche.
Se una pagina viene servita direttamente dalla cache, molte richieste non devono eseguire nuovamente WordPress e PHP.
Questo è particolarmente utile per siti che ricevono frequenti visite da:
motori di ricerca;
crawler AI;
servizi di monitoraggio;
aggregatori.
AI crawler e hosting Xlogic
Sui servizi compatibili Xlogic utilizza tecnologie come:
LiteSpeed Enterprise;
LSCache;
CloudLinux;
Imunify360;
SSD NVMe;
cPanel;
JetBackup.
In un ambiente hosting moderno è quindi possibile analizzare il traffico, controllare gli accessi e distinguere crawler utili da bot indesiderati senza necessariamente applicare un blocco indiscriminato.
☑ aggiorna periodicamente le regole perché i bot cambiano nel tempo.
Domande frequenti sui crawler AI
Cos’è un crawler AI?
È un software automatico utilizzato da un servizio AI per visitare e analizzare pagine Web. La finalità può essere ricerca, training dei modelli oppure recupero di contenuti richiesto dall’utente.
GPTBot e OAI-SearchBot sono la stessa cosa?
No. GPTBot è associato alla raccolta di contenuti che possono essere utilizzati per il training dei modelli OpenAI, mentre OAI-SearchBot viene utilizzato per ChatGPT Search.
Posso bloccare GPTBot ma apparire in ChatGPT Search?
Sì. OpenAI permette di gestire GPTBot e OAI-SearchBot separatamente.
Cos’è ChatGPT-User?
È lo user-agent utilizzato in determinate visite a pagine Web avviate direttamente da utenti ChatGPT o GPT.
ClaudeBot serve alla ricerca?
ClaudeBot è associato al training. Anthropic utilizza invece Claude-SearchBot per la ricerca e Claude-User per determinate richieste avviate dagli utenti.
Posso bloccare ClaudeBot senza bloccare Claude-SearchBot?
Sì. Anthropic documenta i bot separatamente e permette di specificare regole dedicate nel robots.txt.
Google-Extended influenza il ranking Google?
Google dichiara che Google-Extended non influenza l’inclusione del sito in Google Search e non viene utilizzato come segnale di ranking.
Sì. È possibile utilizzare regole separate nel robots.txt.
Devo bloccare Bingbot per impedire il training AI?
Non è consigliabile farlo indiscriminatamente perché Bingbot è il crawler utilizzato anche per Bing Search. Microsoft mette a disposizione controlli specifici e sta evolvendo le proprie modalità di gestione delle preferenze AI.
robots.txt impedisce fisicamente a un bot di entrare?
No. robots.txt comunica una direttiva ai crawler che decidono di rispettarla. Per un blocco tecnico servono firewall, WAF, CDN o altre regole server.
Consentire OAI-SearchBot garantisce che ChatGPT citi il mio sito?
No. Permette al sito di essere eleggibile alla scansione Search, ma non garantisce apparizione, ranking o citazione.
Come posso sapere se ChatGPT sta visitando il mio sito?
Puoi analizzare i log del server e cercare user-agent come OAI-SearchBot, GPTBot e ChatGPT-User.
Come posso sapere se Claude visita il sito?
Cerca nei log user-agent come ClaudeBot, Claude-SearchBot e Claude-User.
Conviene bloccare tutti i crawler AI?
Dipende dagli obiettivi del sito. Bloccarli tutti può ridurre anche le opportunità di essere scoperti attraverso sistemi di ricerca AI.
Conclusioni
Nel 2026 parlare genericamente di crawler AI non è più sufficiente.
Bisogna distinguere almeno tre funzioni:
Search → Training → Agent.
OpenAI utilizza OAI-SearchBot per la ricerca, GPTBot per il training e ChatGPT-User per determinate richieste degli utenti.
Anthropic distingue ClaudeBot, Claude-SearchBot e Claude-User.
Google permette di separare la normale scansione Googlebot dalle preferenze espresse attraverso Google-Extended.
Apple utilizza un meccanismo analogo con Applebot-Extended.
Cloudflare ha ulteriormente formalizzato questa distinzione con i controlli Search, Training e Agent e con la nuova impostazione Disallow AI Training.
La regola più importante è quindi semplice:
non bloccare un crawler soltanto perché contiene la parola “AI” senza prima capire a cosa serve.
Se vuoi comparire nelle ricerche AI ma non desideri autorizzare il training, in molti casi oggi è possibile gestire le due finalità separatamente.
E per sapere se la configurazione funziona davvero, non fermarti al robots.txt:
controlla i log del server, verifica gli user-agent e soprattutto guarda quali codici HTTP ricevono i crawler.
Crawler AI: come bloccare il training senza sparire da Google e dalle ricerche AI
ultima modifica: 2026-09-29T20:28:58+02:00
da Team tecnico Xlogic
RISPETTIAMO LA TUA PRIVACY!
Utilizziamo i cookie per finalità tecniche e con il tuo consenso, anche per "interazioni e funzionalità semplici", "miglioramento dell'esperienza", "misurazione", "targeting e pubblicità", vedi la Cookie Policy. Puoi rifiutare o revocare il consenso in qualsiasi momento; il rifiuto può rendere non disponibili le relative funzioni.
Impostazioni Cookie
Il nostro sito web utilizza cookie funzionali. Questi cookie sono necessari per il corretto funzionamento del sito.
Essential cookies enable basic functions and are necessary for the proper function of the website.
Cookie Preferences
This cookie is used to store the user's cookie consent preferences.
30 days
These cookies are needed for adding comments on this website.
comment_author
Used to track the user across multiple sessions.
Session
comment_author_email
Used to track the user across multiple sessions.
Session
comment_author_url
Used to track the user across multiple sessions.
Session
Google Tag Manager simplifies the management of marketing tags on your website without code changes.
cookiePreferences
Registers cookie preferences of a user
2 years
td
Registers statistical data on users' behaviour on the website. Used for internal analytics by the website operator.
session
Statistics cookies collect information anonymously. This information helps us understand how visitors use our website.
Google Analytics is a powerful tool that tracks and analyzes website traffic for informed marketing decisions.
Used to monitor number of Google Analytics server requests
10 minutes
__utmb
Used to distinguish new sessions and visits. This cookie is set when the GA.js javascript library is loaded and there is no existing __utmb cookie. The cookie is updated every time data is sent to the Google Analytics server.
30 minutes after last activity
__utmc
Used only with old Urchin versions of Google Analytics and not with GA.js. Was used to distinguish between new sessions and visits at the end of a session.
End of session (browser)
__utmz
Contains information about the traffic source or campaign that directed user to the website. The cookie is set when the GA.js javascript is loaded and updated when data is sent to the Google Anaytics server
6 months after last activity
__utmv
Contains custom information set by the web developer via the _setCustomVar method in Google Analytics. This cookie is updated every time new data is sent to the Google Analytics server.
2 years after last activity
__utmx
Used to determine whether a user is included in an A / B or Multivariate test.
18 months
_ga
ID used to identify users
2 years
_gali
Used by Google Analytics to determine which links on a page are being clicked
30 seconds
_ga_
ID used to identify users
2 years
_gid
ID used to identify users for 24 hours after last activity
24 hours
_gat
Used to monitor number of Google Analytics server requests when using Google Tag Manager
1 minute
_gac_
Contains information related to marketing campaigns of the user. These are shared with Google AdWords / Google Ads when the Google Ads and Google Analytics accounts are linked together.